
2026 AI 模型蒸餾:為什麼每一家實驗室都在蒸餾 + 開發者該怎麼用
正在重塑模型市場的安靜轉向
兩年前,「蒸餾」只是研究論文裡的註腳。當你跑不起完整模型時,一個聰明的縮小模型的技巧。來到 2026 年 10 月,這個話題完全反轉了:每一家大型實驗室現在都刻意在蒸餾自己的前沿模型,而 AI 領域裡大量的地緣政治緊張都圍繞著誰在蒸餾誰的模型在打。OpenAI 在三月把 GPT-5.4 Mini 與 Nano 當作預設的低成本層級。Anthropic 的 Claude Haiku 內部跑在一套蒸餾管線上,安靜地伴隨每一次 Sonnet 上線。DeepSeek 整個 R1 系列就是一個蒸餾故事。被問到競爭對手的蒸餾是否算不公平競爭時,Jensen Huang 在九月用一個字回答:「competition(這就是競爭)。」
這篇文章寫給真正用這些系統建構產品的人。不是在爭論智財權的人。那些要為客服代理、程式碼補完功能、即時語音管線選擇模型的人。蒸餾不再是「因為跑不起前沿模型所以去做」的事。它是決定未來兩年哪些模型能勝出的策略動作——而使用它們的方法論,跟多數教學內容說的不一樣。
現在的蒸餾實際長什麼樣
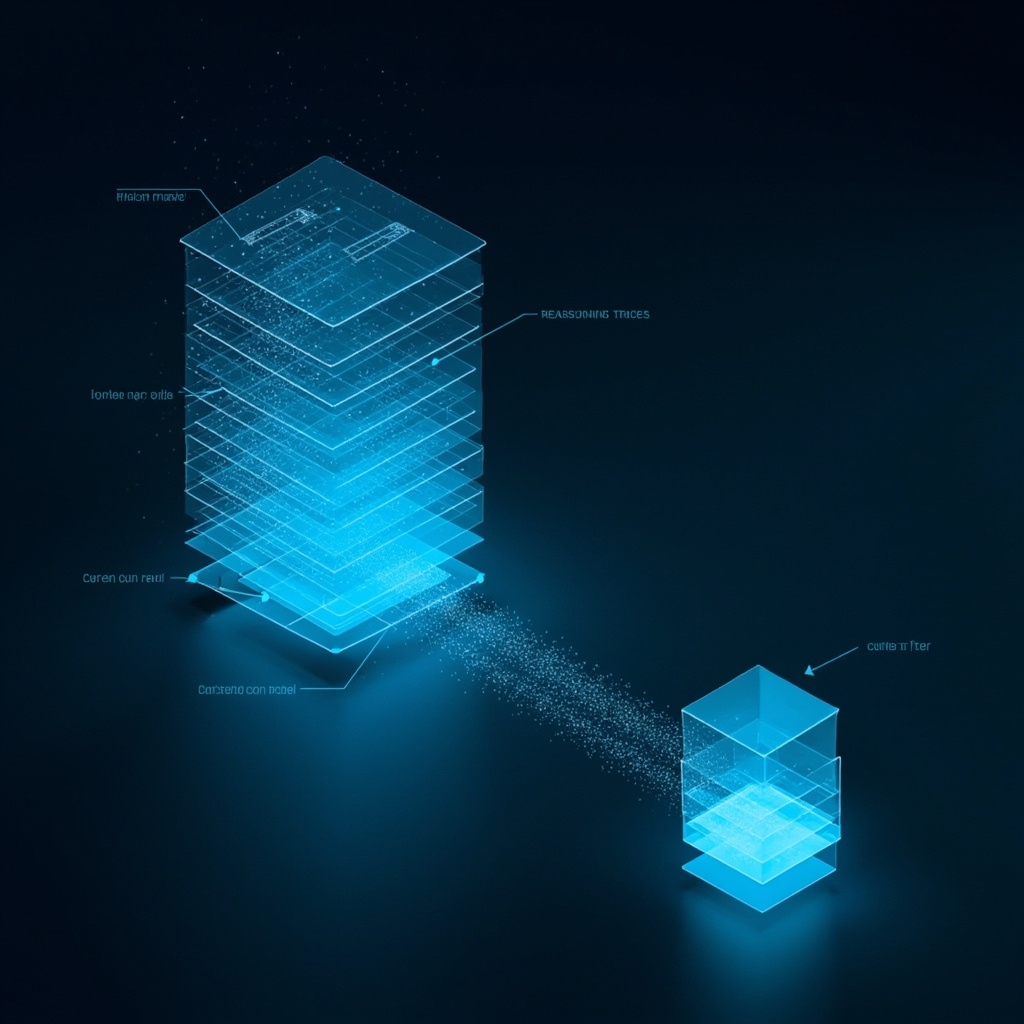
舊式蒸餾:拿一個大的 teacher 模型,訓練一個小的 student 模型去模仿它的輸出,省下推論成本。新式蒸餾更亂、更具策略性,也更具政治性。
現代管線看起來比較不像「小模型模仿大模型」,更像一個持續迴圈。Teacher 產生候選答案、排序輸出和推理軌跡。一位策展者(有時是第二個模型,有時是人類,通常兩者都有)篩選那些能教到東西的軌跡。Student 在篩選過的集合上訓練,有時疊上強化學習,有時加上自己的合成資料層。Student 上線。生產環境中記錄新的軌跡。迴圈重啟。
這就是為什麼 2026 年末的「小模型」這個詞,比「在某個特定任務上的特定能力等級」更不實用。2026 年蒸餾出來的 8B 模型在窄 workflow 上可以勝過 2024 年的前沿 70B。在另一個 workflow 上可能輸得很慘。能力藏在蒸餾配方、課程設計和後訓練資料裡——不在參數量裡。
過去六個月反覆出現的兩個實例:把 DeepSeek R1 蒸餾進 GPT-OSS,產生的模型在某領域語料上微調後保留了驚人的推理能力,卻把推論成本砍了一個數量級。把 Claude Sonnet 蒸餾成內部自用的程式碼審查小型模型,可靠地保留了大約 80–90% 的審查代理品質——但前提是你的蒸餾資料包含模型的實際推理軌跡,而不僅是最終輸出。
為什麼蒸餾變成預設策略
三股力量同時把每一家實驗室推到這裡。算力經濟學是第一個。生產一個前沿 token 的邊際成本下降了,但生產一個「好的」token——也就是能在用戶評估中存活、不只是跑分好看的 token——的邊際成本沒降。蒸餾讓實驗室把昂貴的推理攤提到可以用更高利潤率提供服務的更便宜模型上。
延遲經濟學是第二個。前沿品質的 70B 等級模型對非同步任務沒問題。它對即時語音、自動補完、嵌入式 IDE 建議,或任何需要 200 毫秒以下回應的場景不行。蒸餾出來的小模型是實驗室觸及「讓應用可行」這個延遲層級的方式。OpenAI 把 GPT-5.4 Nano 定為許多程式碼編輯器整合的預設模型,基本上是個披著能力決策外衣的延遲決策。
部署經濟學是第三個,而且是結構性的。裝置端 AI、邊緣推論、有隱私部署需求的受監管產業,以及任何需要在沒有網路時仍可運作的消費產品——它們全都需要能跑在客戶實際擁有的硬體上的模型。蒸餾是通往那條路的唯一途徑。Apple 的 Foundation Models 框架、Google 的裝置端 Gemma、Qualcomm 的 Snapdragon NPU,加上今年冒出頭的 Meta-on-Rayburn 邊緣構想——每個裝置端 LLM 故事都是蒸餾故事。
意外的副作用:便宜的模型不只更小。它們在某個特定意義上也「更對齊」。它們的粗糙稜角被蒸餾管線磨平了,它們的輸出被校準到實驗室偏好的回應風格。對開發者來說這是功能,不是 bug——你不用寫長長的系統提示去壓掉雜訊,就能拿到可預測的行為。
新的模型階層
如果你把 2026 年末的模型市場簡化成「前沿 vs 便宜」,你會多花錢。真正的結構長這樣:
| 層級 | 在 2026 年是什麼 | 什麼時候你會要它 |
|---|---|---|
| 前沿(Frontier) | 實驗室的頂級推理模型。從更早期、更大的研究模型蒸餾而來。 | 困難推理、新穎的研究任務、任何使用者願意等、每次呼叫成本可以高的場景。 |
| 蒸餾 Pro | 在前沿推理軌跡上訓練出來的小模型。例如 GPT-5.4 Mini、Claude Sonnet-lite、Gemini Flash。 | 品質重要、但成本與延遲都是實質約束的生產工作流。2026 年多數 API 的預設值。 |
| 蒸餾 Nano | 被積極壓縮的模型,常搭配量化與稀疏化技巧。GPT-5.4 Nano、Claude Haiku、Phi 等級模型。 | 大量分類、路由、簡單抽取、自動補完、程式碼補完——任何你會做很多次呼叫、每次品質要求中等的場景。 |
| 專家蒸餾(Specialist) | 在某個窄領域語料上蒸餾、只做一件事的小模型——程式碼審查、合約條款抽取、SQL 生成、語音意圖。 | 當你有大量、明確的工作,以及清楚的準確率門檻時。通常是每美元 ROI 最高的選擇。 |
| 開放權重基底 | 你自行託管或微調的開放權重模型。Llama、Mistral、Qwen、GPT-OSS、DeepSeek。 | 隱私、成本上限、延遲底線,或完全控制權。代價是營運複雜度。 |
開發者常犯的錯是把便宜層當作可以互換。它們不能。蒸餾 Pro 模型被校準到廣泛任務。專家蒸餾模型被校準到單一任務。把它們搞混就是你為什麼看到這麼多團隊在路由上超支、或在交付品質上失分的理由。
過去六個月真正改變了什麼
這個故事在 2026 年走得很急。三個轉變對現在的開發者重要。
蒸餾行動變成了國安故事。 Anthropic 和 OpenAI 都在 2026 年 9 月發布了中國實驗室進行工業級蒸餾行動的指控細節。Anthropic 的報告點名 Alibaba、Moonshot AI 和 DeepSeek。追蹤報導把這個活動定性為系統性且持續進行。你怎麼讀這件事,取決於你是把它當智財故事、安全故事還是競爭故事來看。對開發者重要的是,這些實驗室的便宜層模型帶上了政治色彩。一些企業買家正在限制可以使用哪些模型。一些靠近政府的部署無論能力如何都不能用這些模型。
自我蒸餾不再尷尬。 兩年間,實驗室默默蒸餾自己的模型,感覺像在承認前沿拉開得不夠快。那個框架現在不存在了。每一家實驗室現在公開蒸餾自己的模型,蒸餾配方被當作競爭資產。路線圖長這樣:訓練一個巨型研究模型,用它產生策展過的軌跡,把這些軌跡蒸餾進產品線,讓除法巨人退役。Anthropic 的 Claude 系列、Google 的 Gemini Flash、OpenAI 的 GPT-5.4 Mini/Nano——全部這樣蓋出來的。
專家蒸餾的經濟學越過了一條線。 兩年前,蒸餾一個專家模型在算力和資料上貴到只有大企業才做得起。在 2026 年末,你可以用相當克制的預算,為一個窄工作蒸餾出一個能打的專家模型。過去九個月的 Show HN 包括:一個 14MB 的代理型 LLM 給手機、穿戴裝置、智慧家庭和機器人用、在 DRAM 內執行的裝置端 PrismML Bonsai 模型,以及為特定領域蒸餾 GPT-OSS 的開源配方。工具鏈追上來了。
2026 年末的開發者蒸餾攻略
你不需要是前沿實驗室才能受惠。多數開發者應該把蒸餾想成三個工具之一:路由、微調、蒸餾。
第一步:不要蒸餾你量不出來的東西。 任何蒸餾專案最難的部分不是訓練。是評估。你需要一個能捕捉你真正想讓小模型做什麼的評估集——不是泛用跑分。如果你不能用一個數字衡量當前行為和目標行為之間的差距,你就說不清蒸餾是否有用。
第二步:選對 teacher。 前沿模型很少是對的 teacher。一個在你領域微調過的蒸餾 Pro 模型,通常是更好的 teacher,因為它的輸出更一致、產生成本更低。Teacher 的工作是產出你系統產不出的軌跡。對窄任務來說,現良好提示的中階模型常常是更好的 teacher,因為它的失誤可預測也容易過濾。
第三步:策展,不要只傾倒。 幼稚的做法——拿每個 teacher 輸出然後拿去訓練——幾乎從來不是最佳做法。生產中能跑的蒸餾模型是在過濾過的軌跡上訓練出來的:teacher 答對的範例、高信心答案、推理緊實的範例、覆蓋你分佈邊緣的範例。過濾才是祕密武器。
第四步:把蒸餾當成連續迴圈。 最好的結果來自把蒸餾當成持續、而非一次性的團隊。在生產環境跑小模型。捕捉它失敗的案例。把修正蒸餾回下一個版本。這比較接近實驗室內部怎麼做,一次性蒸餾和連續蒸餾之間的差距是真實的。
第五步:留意蒸餾債。 有一個真實的失敗模式:小模型繼承了 teacher 的盲點,但沒有 teacher 那種從盲點中恢復的推理能力。模型聽起來自信,是因為它在自信的答案上訓練出來的。如果你的 teacher 有已知的失敗模式——例如 Claude 蒸餾出來的模型失去某些安全行為,或 DeepSeek 蒸餾模型失去某些護欄——你必須為這件事明確評估。HN 社群用「soul stripping(靈魂剝離)」這個詞在追蹤這件事。它不是比喻。它是可量測的退化模式。
現在值得做的事 vs. 仍然被過度吹捧的事
現在值得做。 如果你有一個高流量的 AI 功能、輸入可預測,為它蒸餾一個專家模型。在 2026 年末的單位經濟學下,每個月 token 量在幾百萬以上的工作流這都是無腦選擇。障礙已經不再是算力。是評估紀律。
現在值得做。 把蒸餾當成「我要怎麼讓它更快更便宜」的預設答案,而不是例外。路由是 2024–2025 年的模式。蒸餾是 2026–2027 年的模式。它們有重疊,但大規模蒸餾的經濟性在高流量工作流上勝過路由。
現在值得做。 對消費產品,把裝置端推論當成真正的部署目標來規劃,而不是行銷核取方塊。那個硬體故事在 2026 年追上來了。在那個硬體上能跑的模型故事,大多是蒸餾故事。
仍然被過度吹捧。 蒸餾讓你可以跳過底層模型選擇這個想法。不能。如果你從一個在你領域很差的 teacher 蒸餾,你拿到的是一個在你領域上很差的小模型,只是比較快。蒸餾是好上游決策的放大器,也是壞上游決策的快速通道。
仍然被過度吹捧。 完全自主、沒有任何人類策展的自我蒸餾迴圈。當前這一代自我改良故事是真的,但每個能跑的版本都有人在迴圈裡負責過濾、評估和領域判斷。把自我蒸餾當免人工處理,是快速在生產環境中漂移的方式。
仍然被過度吹捧。 「蒸餾就是偷」這個框架。技術上,蒸餾是一個有許多合法應用的通用技術,IP 的論點只在特定的對抗情境下才有趣。對開發者來說,這大多是雜訊。專注在能力和成本上,不要被政治框架分心。
常見陷阱
把便宜層當成可以互換。 蒸餾 Pro 模型和專家蒸餾模型是不同的產品。用錯的話,你不是燒 token 就是錯過品質底線。
蒸餾時訓練資料多樣性不足。 常見的失敗是在 teacher 輸出的窄子集上蒸餾,然後出貨一個在五個查詢上能跑、第六個就崩潰的模型。修法比大家想要的難:覆蓋長尾,不要只覆蓋快樂路徑。
蒸餾債出現了才正視。 蒸餾模型會失去 teacher 原本擁有的能力。如果你不為特定的損失做評估,你出貨的是你沒注意到的退化。先建評估集再建訓集。
把蒸餾和微調搞混。 微調調整模型在某個領域的行為。蒸餾把模型的能力轉移到更小的體積。它們有重疊但不一樣。微調過的小模型不自動是蒸餾模型,工作流、資料和經濟性都不同。
跳過 productionizing。 一個需要離線蒸餾執行、人工管線、沒人維護的蒸餾模型,是三個月後會壞掉的模型。把蒸餾管線當成任何其他生產系統一樣對待:版本化資料、版本化模型、自動化重跑、在漂移時告警。
蒸餾是正確選擇 vs. 應該跳過的時候
| 用蒸餾的情境… | 跳過蒸餾的情境… |
|---|---|
| 你有高流量、定義明確的工作流,單位成本重要 | 你還在迭代工作流本身 |
| 你需要前沿模型達不到的延遲 | 你做的是一次性、低流量的任務,前沿品質勝出 |
| 你需要裝置端或私有部署 | 你定義不出一個穩定的評估集 |
| 你有一個可以當 teacher 的、由前沿驅動的可用版本 | 你還沒搞懂這個工作流的「好」長什麼樣 |
| 工作流輸入穩定、成功訊號清楚 | 用例真的很新,你不知道要在什麼分佈上訓練 |
| 你負擔得起維護管線的營運成本 | 你這週就需要結果、又沒意願做幾週的評估 |
常見問題
蒸餾只是為了降低成本,還是也能提升能力?
它降低推論層的成本。它不提升由 teacher 和資料決定的底層能力天花板。它能做的,是把能力集中到更小的體積,也就是更好的成本/品質取捨。對窄任務,一個蒸餾得當的小模型可以勝過前沿,因為它在更緊的分佈上訓練。
我需要自己訓練 teacher 才能蒸餾嗎?
不用。多數成功的專案從託管式的前沿或蒸餾 Pro API 蒸餾。客製化的部分是怎麼過濾、策展和結構化訓練資料,不是自己訓練 teacher。
我應該考慮蒸餾的最小模型規模是多少?
在 2026 年末,多數生產工作流的甜蜜區間大約是 1B–8B 參數,100M–500M 模型對非常窄的分佈和意圖任務可行。1B 以下,你會開始失去蒸餾應該保留的能力。
蒸餾專案實際上要花多久?
第一輪的專家蒸餾通常跑二到六週,前提是你有清楚的評估集、能取用 teacher 軌跡。瓶頸通常是評估,不是訓練。連續蒸餾迴圈則是持續跑,週期用天而不是週計算。
開放權重蒸餾實際上可行嗎?
可以,但帶但書。Llama、Mistral、Qwen、GPT-OSS、DeepSeek 系列都支援蒸餾工作流。生產可行性比較少取決於基底模型,多取決於你的評估紀律、部署基礎設施,以及維護管線的意願。對受隱私約束的工作流,這是預設答案。
結語
2026 年末的模型市場不是「前沿對其他所有人」的故事。它是一個分層的故事,每一層都越來越是蒸餾的故事。對開發者真正有趣的問題不再是「哪個模型最好」——而是「對這個工作流、這個量、這個延遲預算,哪個蒸餾模型是正確答案,讓它保持新鮮要花多少成本」。這比我們 2024 年在問的那個問題好回答多了,而搞懂它的人會默默勝過還在追逐前沿的人。